全球数据整合 支持100+数据源的关系型、NoSQL、云存储与API处理方案
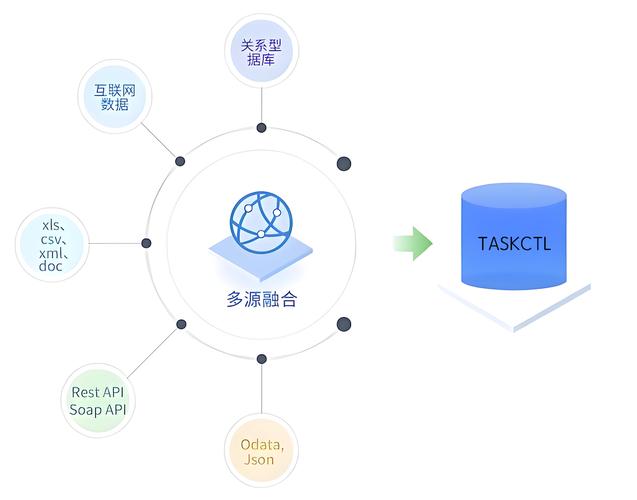
在当今数据驱动的世界中,企业面临着从多样化的数据源中提取、处理和存储数据的挑战。为了构建灵活且可扩展的数据架构,支持超过100种数据源已成为现代数据平台的核心能力。本文将探讨如何整合关系型数据库、NoSQL数据库、云存储服务以及API,实现高效的数据处理和存储支持服务。
1. 关系型数据库(RDBMS)
关系型数据库是传统的数据存储方式,适用于结构化数据。常见的关系型数据库包括:
- MySQL
- PostgreSQL
- Oracle
- Microsoft SQL Server
- MariaDB
- SQLite
- IBM Db2
- SAP HANA
- Amazon RDS
- Google Cloud SQL
这些数据库通过JDBC/ODBC驱动或专用连接器集成,支持SQL查询和事务处理。
2. NoSQL数据库
NoSQL数据库为半结构化或非结构化数据提供灵活的模式,适合大规模分布式存储。主要类型包括:
- 文档型:MongoDB, Couchbase, Amazon DocumentDB
- 键值型:Redis, DynamoDB, Riak
- 列族型:Cassandra, HBase, ScyllaDB
- 图数据库:Neo4j, Amazon Neptune, JanusGraph
- 时序数据库:InfluxDB, TimescaleDB, Prometheus
这些数据库通常通过原生API或SDK进行集成。
3. 云存储服务
云存储服务提供可扩展的对象存储,适用于海量非结构化数据。常见的云存储包括:
- Amazon S3
- Google Cloud Storage
- Azure Blob Storage
- IBM Cloud Object Storage
- Alibaba Cloud OSS
- Oracle Cloud Object Storage
- Backblaze B2
- Wasabi
- MinIO
- Ceph
集成方式通常通过REST API或SDK实现。
4. API数据处理
API是获取外部数据的重要途径。常见的API类型包括:
- RESTful API
- GraphQL API
- SOAP API
- WebSocket
- gRPC
- OData
- JSON-RPC
- XML-RPC
通过API网关、连接器或自定义代码,可以实时或批量获取数据。
5. 其他数据源
除了上述类别,还有许多其他数据源需要支持,如:
- 文件系统:本地文件、FTP、SFTP、HDFS
- 消息队列:Kafka, RabbitMQ, Amazon SQS, Google Pub/Sub
- 大数据平台:Hadoop, Spark, Hive, Presto
- 日志系统:Elasticsearch, Splunk, Fluentd
- SaaS应用:Salesforce, SAP, Workday, Google Analytics
- 社交媒体:Twitter, Facebook, LinkedIn
总计超过100种数据源。
6. 数据处理和存储支持服务
为了有效整合这些数据源,需要以下支持服务:
- 数据集成:使用ETL/ELT工具(如Apache NiFi, Talend, Informatica)或数据虚拟化技术。
- 数据存储:采用数据湖、数据仓库或数据湖仓一体架构(如Databricks, Snowflake, BigQuery)。
- 数据处理:批处理(Spark, MapReduce)和流处理(Flink, Kafka Streams)。
- 数据治理:元数据管理、数据质量、数据安全。
- 数据服务:通过API或查询接口提供数据访问。
7. 架构建议
构建支持100+数据源的平台,建议采用以下架构:
- 连接层:提供各种数据源的连接器,支持插件化扩展。
- 采集层:批量和实时数据采集。
- 存储层:统一存储,如数据湖。
- 处理层:分布式计算引擎。
- 服务层:数据API、可视化、分析。
结论
支持100种以上数据源的数据处理和存储服务是现代数据架构的关键。通过整合关系型数据库、NoSQL数据库、云存储和API,企业可以打破数据孤岛,实现数据驱动的决策。随着技术的发展,数据源的数量和类型将继续增长,构建灵活、可扩展的平台至关重要。
本文概述了主要数据源类别和集成方法,为构建综合数据平台提供了参考。自动化和AI将在数据集成中发挥更大作用。
如若转载,请注明出处:http://www.qjxmcdh.com/product/52.html
更新时间:2026-10-05 09:31:08